进程定义
Process: 运行中的程序的一个副本,是被载入内存的一个指令集合,是资源分配的单位
- 进程ID(Process ID,PID)号码被用来标记各个进程
- UID、GID、和SELinux语境决定对文件系统的存取和访问权限
- 通常从执行进程的用户来继承
- 存在生命周期
进程创建:
- init:第一个进程,从 CentOS7 以后为systemd
- 进程:都由其父进程创建,fork(),父子关系,CoW:Copy On Write
查看进程或者线程的命令
pstree -p
# 在大括号里面的为线程
# 小括号的为进程
也可以通过查看proc文件系统内的文件查看线程数量
cat /proc/${PID}/status
查看进程对应的二进制文件
ls -l /proc/${PID}/exe
查看进程中的线程 - 包括进程本身
grep -i threads /proc/PID/status
查看进程的二进制文件
ll /proc/PID/exe
查看进程的相关信息文件
ls /proc/1024/
查看多进程模型
 pstree -p | grep nginx
     |-nginx(1160)-+-nginx(1161)
     |       `-nginx(1162)
多线程查看
pstree -p | grep redis
     |-redis-server(2831)-+-{redis-server}(2833)
     |           |-{redis-server}(2834)
     |           |-{redis-server}(2835)
     |           `-{redis-server}(2836)
Page Frame: 页框,用存储页面数据,存储Page 4k
getconf -a |grep -i size进程内存使用问题
1、内存泄漏:Memory Leak
指程序中用malloc或new申请了一块内存,但是没有用free或delete将内存释放,导致这块内存一直处于占用状态
2、内存溢出:Memory Overflow
指程序申请了10M的空间,但是在这个空间写入10M以上字节的数据,就是溢出
3、内存不足:OOM
OOM 即 Out Of Memory,”内存用完了”,在情况在java程序中比较常见。系统会选一个进程将之杀死,在日志messages中看到类似下面的提示
Jul 10 10:20:30 kernel: Out of memory: Kill process 9527 (java) score 88 or sacrifice child当JVM因为没有足够的内存来为对象分配空间并且垃圾回收器也已经没有空间可回收时,就会抛出这个error,因为这个问题已经严重到不足以被应用处理
产生原因:
- 给应用分配内存太少:比如虚拟机本身可使用的内存(一般通过启动时的VM参数指定)太少。
- 应用用的太多,并且用完没释放,浪费了。此时就会造成内存泄露或者内存溢出。
解决办法:
1,限制java进程的max heap,并且降低java程序的worker数量,从而降低内存使用
2,给系统增加swap空间
设置内核参数(不推荐),不允许内存申请过量:
# overcommit_memory默认值
sysctl -a|grep commit
vm.overcommit_memory = 0
echo 2 > /proc/sys/vm/overcommit_memory
echo 80 > /proc/sys/vm/overcommit_ratio
echo 2 > /proc/sys/vm/panic_on_oom
说明:
Linux默认是允许memory overcommit的,只要你来申请内存我就给你,寄希望于进程实际上用不到那么多内存,但万一用到那么多了呢?Linux设计了一个OOM killer机制挑选一个进程出来杀死,以腾出部分内存,如果还不够就继续。也可通过设置内核参数 vm.panic_on_oom 使得发生OOM时自动重启系统。这都是有风险的机制,重启有可能造成业务中断,杀死进程也有可能导致业务中断。所以Linux 2.6之后允许通过内核参数 vm.overcommit_memory 禁止memory overcommit。
vm.overcommit_memory 接受三种取值
0 – Heuristic overcommit handling. 这是缺省值,它允许overcommit,但过于明目张胆的overcommit会被拒绝,比如malloc一次性申请的内存大小就超过了系统总内存。Heuristic的意思是“试探式的”,内核利用某种算法猜测你的内存申请是否合理,它认为不合理就会拒绝overcommit。
1 – Always overcommit. 允许overcommit,对内存申请来者不拒。内核执行无内存过量使用处理。使用这个设置会增大内存超载的可能性,但也可以增强大量使用内存任务的性能。
2 – Don’t overcommit. 禁止overcommit。 内存拒绝等于或者大于总可用 swap 大小以及overcommit_ratio 指定的物理 RAM 比例的内存请求。如果希望减小内存过度使用的风险,这个设置就是最好的。
进程状态
运行态:running
就绪态:ready
睡眠态:分为两种,可中断:interruptable,不可中断:uninterruptable
停止态:stopped,暂停于内存,但不会被调度,除非手动启动
僵死态:zombie,僵尸态,结束进程,父进程结束前,子进程不关闭,杀死父进程可以关闭僵死态的子进程
ps aux 命令STAT列下各字母代表的含义
STAT:进程状态
R:running
S: interruptable sleeping 可中断
D: uninterruptable sleeping 不可中断
T: stopped
Z: zombie 僵尸
+: 前台进程
l: 多线程进程
L:内存分页并带锁
N:低优先级进程
<: 高优先级进程
s: session leader,会话(子进程)发起者
I:Idle kernel thread,CentOS 8 新特性
ni: nice值
pri: priority 优先级
rtprio: 实时优先级
psr: processor CPU编号
孤儿进程
如果在子进程在退出前,父进程先退出,这时子进程将成为孤儿进程,因为它的父进程已经死了。孤儿进程会被PID=1的systemd进程收养,成为systemd的子进程.
注意,孤儿进程还会继续运行,而不会随父进程退出而终止,只不过其父进程发生了改变。
IPC 进程间通信
IPC: Inter Process Communication
1、同一主机
pipe 管道,单向传输
socket  套接字文件,双工通信
Memory-maped file  文件映射,将文件中的一段数据映射到物理内存,多个进程共享这片内存
shm shared memory 共享内存
signal 信号
Lock  对资源上锁,如果资源已被某进程锁住,则其它进程想修改甚至读取这些资源,都将被阻塞,直到锁被打开
semaphore 信号量,一种计数器,
2、不同主机:socket=IP和端口号
RPC remote procedure call
MQ 消息队列,生产者和消费者,如:Kafka,RabbitMQ,ActiveMQ
系统内置函数可以直接被其他进程直接调用
# ubuntu系统函数文件位置
/lib/lsb/init-functions
# CentOS系统函数文件位置
/etc/init.d/functions
进程管理和性能相关工具
进程树 pstress
pstree 可以用来显示进程的父子关系,以树形结构显示
pstree  [OPTION] [ PID | USER ]
常用选项:
 -p 显示PID
 -T 不显示线程thread,默认显示线程
 -u 显示用户切换
 -H pid 高亮显示指定进程及其前辈进程
扩展: lsof -Pti :80  #查看端口为80的进程的PID,不知道进程名字的时候使用
进程信息ps
ps 即 process state,可以进程当前状态的快照,默认显示当前终端中的进程,Linux系统各进程的相关信息均保存在/proc/PID目录下的各文件中
ps [OPTION]...
常用选项
a 选项包括所有终端中的进程
x 选项包括不链接终端的进程
u 选项显示进程所有者的信息
f 选项显示进程树,相当于 --forest
k|--sort 属性 对属性排序,属性前加 - 表示倒序
o 属性… 选项显示定制的信息 pid、cmd、%cpu、%mem
L 显示支持的属性列表
 -C cmdlist 指定命令,多个命令用,分隔
 -L 显示线程
 -e 显示所有进程,相当于-A
 -f 显示完整格式程序信息
 -F 显示更完整格式的进程信息
 -H 以进程层级格式显示进程相关信息
 -u userlist 指定有效的用户ID或名称
 -U userlist 指定真正的用户ID或名称
 -g gid或groupname 指定有效的gid或组名称
 -G gid或groupname 指定真正的gid或组名称
 -p pid 显示指pid的进程
 --ppid pid 显示属于pid的子进程
 -t ttylist 指定tty,相当于 t
 -M 显示SELinux信息,相当于Z
ps 输出属性
C :  ps -ef 显示列 C 表示cpu利用率
VSZ: Virtual memory SiZe,虚拟内存集,线性内存
RSS: ReSident Size, 常驻内存集
STAT:进程状态
    R:running
    S: interruptable sleeping
    D: uninterruptable sleeping
    T: stopped
    Z: zombie
    +: 前台进程
    l: 多线程进程
    L:内存分页并带锁
    N:低优先级进程
    <: 高优先级进程
    s: session leader,会话(子进程)发起者
    I:Idle kernel thread,CentOS 8 新特性
ni: nice值
pri: priority 优先级
rtprio: 实时优先级
psr: processor CPU编号
示例:
ps axo pid,cmd,psr,ni,pri,rtprio
#常用组合
aux
-ef
-eFH
-eo pid,tid,class,rtprio,ni,pri,psr,pcpu,stat,comm
axo stat,euid,ruid,tty,tpgid,sess,pgrp,ppid,pid,pcpu,comm
#常用示例
#按CPU利用率倒序排序
ps aux k -%cpu
ps axo pid,cmd,%cpu,%mem k -%cpu
#按内存倒序排序
ps axo pid,cmd,%cpu,%mem --sort -%mem
进程状态top命令
用于实时显
示系统的运行状况,特别是各个进程的资源和性能使用情况。它提供了一个动态更新的视图,帮助系统管理员和用户监控系统的健康状态。
命令格式:
top -hv | -bcEHiOSs1 -d secs -n max -u|U user -p pid(s) -o field -w [cols]

常见选项
  -n N #刷新多少次后退出
  -d N #指定刷新时间间隔,默认为3秒
一般选项
  -h|v #显示帮助
  -b  #显示全部所有进程
  -c     #显示命令信息
  -E{k|m|g|t|p|e} #指定内存显示单位
  -H  #线程模式
  -1 #十进制数字1,在首部分别显示每颗CPU信息
  -p PID #显示指定进程的数据
  -u|U user  #查看指定用户的进程
  -w cols #指定输出内容显示宽度
手动刷新:
  在top运行时,可以通过输入回车或空格来手动刷新显示。
退出:
  按q键可以退出top命令。
排序命令
  P或Shift+p:按CPU使用率对进程进行排序。默认是降序排列,再次按键则切换为升序。
  M或Shift+m:按内存使用量RES对进程进行排序。默认是降序排列,再次按键则切换为升序。
    在计算机系统中,RES(Resident Set Size)即常驻集大小,是指进程实际占用的物理内存大小
  N:按进程ID排序 - 降序。
  T:按运行时间TIME或累积时间对任务排序。
 o或Shift+o:设置排序的关键字,可以根据需要选择不同的排序依据。
进程操作命令
  k:杀死指定的进程。系统会提示输入进程号和要发送的信号,默认信号是SIGTERM。如果要强行杀死进程,可以输入SIGKILL(信号编号为9)。
  r:改变某个进程的优先级。需要输入进程号和新的nice值,最后按Enter
显示设置命令
  c:切换是否显示每个进程的完整命令行。
  f或Shift+f:进入或离开自定义显示字段模式,可以添加或移除显示的列。
  d:改变两次屏幕刷新之间的延时时间。
  t:显示当前时间、系统运行时间以及空闲/繁忙周期,尤其是图形比例图。
  i:开启或关闭忽略闲置(idle)和僵死(zombie)进程的显示
视图切换命令
0、1、2、3:在不同视图间切换。
  第一种视图显示单个CPU使用情况,
  第二~四种可能涉及多核或NUMA节点视图。
其他命令
  h:显示帮助信息,列出所有交互式命令及其简短说明。
  z(在某些版本中):在彩色和普通模式之间切换显示。
top命令字段解析图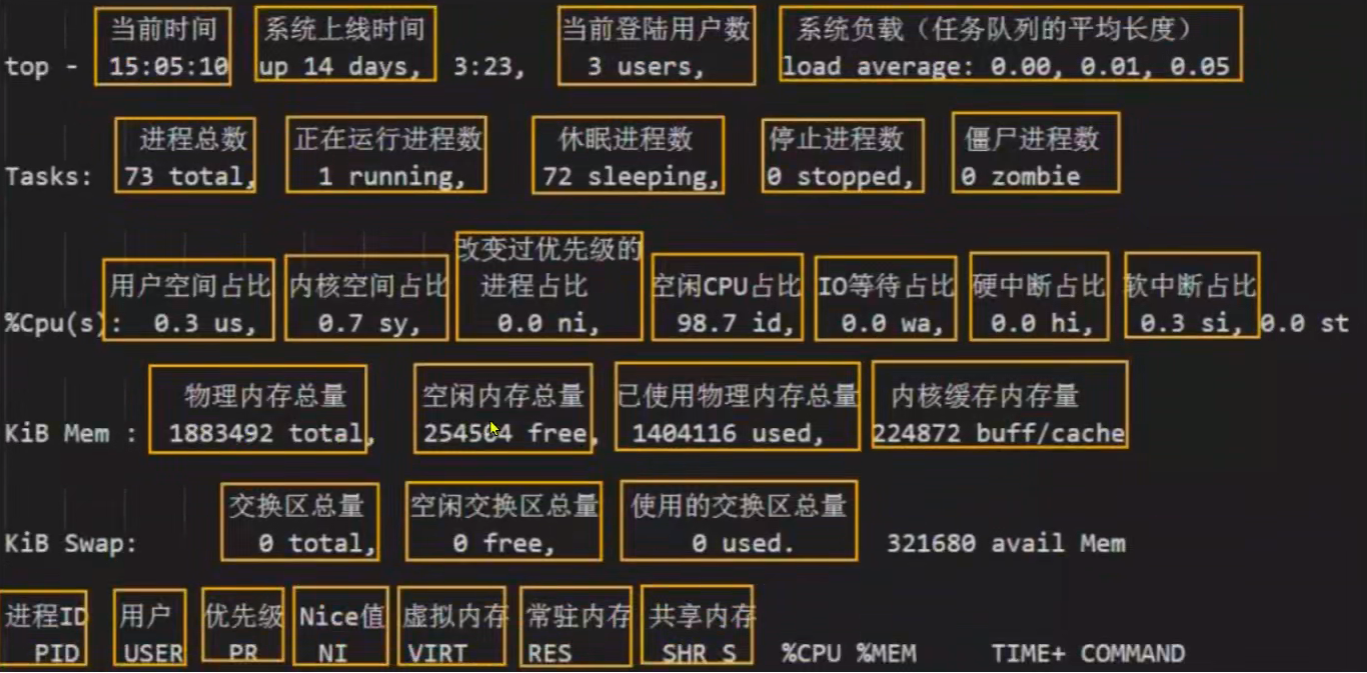
清理缓存
向/proc/sys/vm/drop_caches中写入相应的修改值,会清理缓存。建议先执行sync(sync 命令将所有未写的系统缓冲区写到磁盘中,包含已修改的 i-node、已延迟的块 I/O 和读写映射文件)。执行echo1、2、3 至 /proc/sys/vm/drop_caches, 达到不同的清理目的。

如果因为是应用有像内存泄露、溢出的问题时,从swap的使用情况是可以比较快速可以判断的,但通过执行free 反而比较难查看。但核心并不会因为内存泄露等问题并没有快速清空buffer或cache(默认值是0),生产也不应该随便去改变此值。

一般情况下,应用在系统上稳定运行了,free值也会保持在一个稳定值的。当发生内存不足、应用获取不到可用内存、OOM错误等问题时,还是更应该去分析应用方面的原因,否则,清空buffer,强制腾出free的大小,可能只是把问题给暂时屏蔽了。

排除内存不足的情况外,除非是在软件开发阶段,需要临时清掉buffer,以判断应用的内存使用情况;或应用已经不再提供支持,即使应用对内存的时候确实有问题,而且无法避免的情况下,才考虑定时清空buffer。

释放页面缓存(pagecache)
         echo 1 > /proc/sys/vm/drop_caches
释放目录项缓存(dentries)和索引节点缓存(inodes)
         echo 2 > /proc/sys/vm/drop_caches
释放页面缓存、目录项缓存和索引节点缓存:
         echo 3 > /proc/sys/vm/drop_caches
vmstat命令
vmstat命令生成的报告可用于平衡系统负载活动,帮助用户快速获取当前系统的负载情况,进行系统性能调优、故障排查等操作。具体来说,它可以:
监测系统的整体负载情况:
    了解系统的CPU、内存、磁盘、网络等性能指标,以及进程数量和状态等信息。
分析系统性能问题:
    通过观察系统的CPU使用率、内存占用、磁盘I/O等指标,快速定位系统的性能瓶颈,找到导致系统负载过高、响应变慢等问题的原因。
监测系统的稳定性:
    通过连续监测系统的负载情况,识别出系统的周期性波动,以及系统负载变化的规律,从而更好地管理系
统资源,保证系统的稳定性。
命令解析
命令格式
vmstat [options] [delay [count]]

常用选项
  -a|--active      #分开显示活动和非活动内存
  -s|--stats      #显示事件统计
  -d|--disk      #统计磁盘设备相关信息
  -D|--disk-sum     #综合统计磁盘
  -p|--partition <dev> #统计指定分区
  -S|--unit <char>   #指定显示单位 k|K|m|M
  -w|--wide       #以宽格式显示
  -t|--timestamp    #显示时间
显示项说明:
vmstat
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 1  0      0 1807476  36004 1276548    0    0  1219   104  792 1879  5 12 82  1  0
procs:
  r #可运行(正运行或等待运行)进程的个数,和核心数有关
  b #处于不可中断睡眠态的进程个数(被阻塞的队列的长度)
memory:
  swpd #交换内存的使用总量
  free #空闲物理内存总量
  buffer #用于buffer的内存总量
  cache #用于cache的内存总量
swap:
  si #从磁盘交换进内存的数据速率(kb/s)
  so #从内存交换至磁盘的数据速率(kb/s)
io:
  bi #从块设备读入数据到系统的速率(kb/s)
  bo #保存数据至块设备的速率
system:
  in #interrupts 中断速率,包括时钟
  cs #context switch  进程切换速率
cpu:
  us #Time spent running non-kernel code
  sy #Time spent running kernel code
  id #Time spent idle. Linux 2.5.41前,包括IO-wait time.
  wa #Time spent waiting for IO.  2.5.41前,包括in idle
  st #Time stolen from a virtual machine.2.6.11前, unknown.
命令示例
显示当前时间点虚拟内存数据
vmstat
每秒显示一次
vmstat 1
显示统计数据
vmstat -s
执行检测
vmstat -n 1

从磁盘读数据,写入到内存中
[root@rocky9 ~]# dd if=/dev/nvme0n1 of=/dev/null
会看检测
[root@rocky9 ~]# vmstat -n 1
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
r  b  swpd  free  buff  cache  si  so   bi   bo  in  cs us sy id wa st
1  0    0 606768  63972 666272   0   0 61336   0  622  188 10 15 75  0  0
1  0    0 487824 182756 666540   0   0 118784   0 1088  172 20 29 51  0  0
1  0    0 368884 301540 666800   0   0 118784   0 1080  158 22 28 51  0  0
1  0    0 245912 424420 667092   0   0 122880   0 1110  171 19 30 50  0  0
结果显示:
bi 显示大量数据的操作,因为内存有大量的数据输入。

从磁盘读数据,写入到内存中
[root@rocky9 ~]# dd if=/dev/zero of=/tmp/1.txt bs=1M count=1024
会看检测
[root@rocky9 ~]# vmstat -n 1
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
r  b  swpd  free  buff  cache  si  so   bi   bo  in  cs us sy id wa st
4  0  3608 742608    0 669400   0   0   49 131072  571  203  0 21 79  0  0
4  0  3608 168556    0 1252040   0   0   0 557056 1191  330  1 74 22  2  0
0  0  3608  74480    0 1345804   0   0   4 245760  496  437  0 16 83  1  0

结果显示:
bo 显示大量数据的操作,因为内存有大量的数据输入。
vmstat案例
假设你管理着一台运行多个服务的 Linux 服务器,近期发现系统响应速度变慢,你怀疑是系统资源出现了瓶颈,这时可以使用 vmstat 命令来帮助排查问题。
执行命令查看数据
vmstat -S m
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
r  b  swpd  free  buff   cache  si  so   bi   bo  in   cs   us  sy  id  wa  st
3  1   100  512   200    1500   0   0    5    2   100  200  30  20  45   5  0
procs 部分:
  r:表示运行队列中正在运行和等待运行的进程数。如果这个数字持续大于系统的 CPU 核心数,说明CPU 可能处于过载状态。
  b:表示处于阻塞状态的进程数。
cpu 部分:
  us:表示用户态程序占用 CPU 的时间百分比。
  sy:表示内核态程序占用 CPU 的时间百分比。
  id:表示 CPU 空闲时间百分比。
  wa:表示等待 I/O 完成而使 CPU 空闲的时间百分比。
  st:表示被虚拟机偷走的 CPU 时间百分比(在虚拟机环境中有用)。
结果分析:
    从上述输出结果来看,r 值为 3,大于服务器的 CPU 核心数(假设为 2),说明 CPU 比较繁忙;wa值为 5%,表示有一定的 I/O 等待时间;swpd 值为 100MB,说明系统已经开始使用交换空间,可能存在内存不足的情况。综合这些信息,可以初步判断系统性能问题可能是由于 CPU 过载和内存不足共同导致的。

采取措施
1 优化内存使用:
    检查系统中是否有不必要的程序占用大量内存,考虑关闭一些不常用的服务或进程,以释放内存。同时,可以调整系统的内存缓存策略,根据实际业务需求合理分配 buff 和 cache 的大小。
2 优化 CPU 性能:
    查看占用 CPU 较高的进程,分析其是否存在性能问题,如是否有死循环、复杂的计算逻辑等。对于一些非关键的高 CPU 占用进程,可以考虑降低其优先级,让系统资源优先分配给更重要的进程。
3 增加硬件资源:
    如果条件允许,可以考虑增加物理内存,以减少交换空间的使用,提高系统性能。同时,也可以考虑升级CPU,以满足系统对计算能力的需求。
lsof命令
lsof:list open files,查看当前系统文件的工具。在linux环境下,一切皆文件,用户通过文件不仅可以访问常规数据,还可以访问网络连接和硬件如传输控制协议 (TCP) 和用户数据报协议 (UDP)套接字等,系统在后台都为该应用程序分配了一个文件描述符 。
命令格式
  lsof [options...] [names]
常用选项
  -Pti #根据端口获取进程id
一般选项
  -c cmd #列出指定进程所打开的文件
  -g #列出GID号进程详情
  +d dir #列出目录下被打开的文件
  +D dir #递归列出目录下被打开的文件
  -n dir #列出使用NFS的文件
  -i condition #列出符合条件的进程
  -p pid #列出指定进程号所打开的文件
  -u #列出UID号进程详情
  -n #不反向解析网络名字
  -t|--tables #只更新打开文件的表,而不显示它们
使用示例
根据端口获取进程id
lsof -Pti :80
查看指定进程打开的文件
lsof -p 1270
查看指定程序打开的文件
lsof -c httpd

从内存中恢复己删除的文件
tail -f /var/log/messages
另开一个终端,删除文件
rm -rf /var/log/messages
ls /var/log/messages
ls: cannot access '/var/log/messages': No such file or directory
找出进程
[root@rocky9 ~]# ps aux | grep tail
root     6037  0.0  0.1 217128  976 pts/4   S+  02:29  0:00 tail -f /var/log/messages
查看内存映射
[root@rocky9 ~]# ll /proc/6037/fd/
total 0
lrwx------ 1 root root 64 May 29 02:32 0 -> /dev/pts/4
lrwx------ 1 root root 64 May 29 02:32 1 -> /dev/pts/4
lrwx------ 1 root root 64 May 29 02:32 2 -> /dev/pts/4
lr-x------ 1 root root 64 May 29 02:32 3 -> '/var/log/messages (deleted)'
lr-x------ 1 root root 64 May 29 02:32 4 -> anon_inode:inotify
打开,文件内容还在
[root@rocky9 ~]# cat /proc/6037/fd/3
恢复
[root@rocky9 ~]# cat /proc/6037/fd/3 > /var/log/messages
并发执行网段检测脚本
#!/bin/bash

#顺序执行
net=10.0.0
for i in {1..254}
do
    ping -c1 -W1 $net.$i &> /dev/null && echo $net.$i is up || echo $net.$i is down
done

#并发执行
net=10.0.0
for i in {1..254}
do
{
        ping -c1 -W1 $net.$i &> /dev/null && echo $net.$i is up || echo $net.$i is
down
}&
done

wait
周期任务管理
系统cron任务
    操作系统自带的cron 任务,系统维护作业,/etc/crontab 主配置文件, /etc/cron.d/ 子配置文件
用户cron任务
    每个用户自己名下的 cron 任务
    红帽系统保存在 /var/spool/cron/USERNAME,
    Ubuntu 系统存放在/var/spool/cron/crontabs/USERNAME,利用 crontab 命令管理
cron 程序日志文件
Centos系统
ll /var/log/cron
Ubuntu系统
ll /var/log/syslog
系统cron 任务相关文件
etc/crontab #配置文件
/etc/cron.d/ #配置文件
/etc/cron.hourly/ #脚本
/etc/cron.daily/ #脚本
/etc/cron.weekly/ #脚本
/etc/cron.monthly/ #脚本
crontab命令
命令格式
crontab [-u user] [-l | -r | -e] [-i]
常用选项
  -l #列出所有任务
  -e #编辑任务
  -r #移除所有任务
  -i #同-r一同使用,以交互式模式移除指定任务
  -u user #管理特定用户的cron, 仅root有权限操作

cron中的环境变量
    cron中的环境变量和bash 中的环境变量不一致,所以在写 cron 任务时,命令路径要求写全路径,或先在首部先定义PATH。
查看cron任务
crontab -l
root 用户可以查看指定用户的 crontab
crontab -u sswang -l
有些操作系统,可能会在首次编辑时,提示选择编辑工具
crontab -e
no crontab for root - using an empty one
Select an editor.  To change later, run 'select-editor'.
 1. /bin/nano     <---- easiest
 2. /usr/bin/vim.basic
 3. /usr/bin/vim.tiny
 4. /bin/ed
Choose 1-4 [1]:

如果没有在此处选择,可以写配置文件修改编辑工具
echo "export EDITOR=vim" >> /etc/profile.d/env.sh
. /etc/profile.d/env.sh
有cron任务的用户都会有对应的文件
ls -l /var/spool/cron/
最后编辑:于浩 更新时间:2026-07-12 22:32
